
实时语音识别
接口说明
实时语音识别,通过Websocket长连接对实时语音流进行识别,适用于会议字幕、视频直播等长时间不间断识别的场景。
支持的音频格式: 采样率为16K,采样深度为16bit的pcm_s16le音频
接口要求
| 内容 | 说明 |
|---|---|
| 请求协议 | wss |
| 请求地址 | wss://sdk.cloudroom.com/CLOUDMEETING-API/v1/recognit?{请求参数} |
| 字符编码 | UTF-8 |
| 响应格式 | 统一采用JSON格式 |
| 音频属性 | 采样率16k、位长16bit、单声道 |
| 音频格式 | pcm |
| 数据发送 | 建议音频流每100ms发送3200字节 |
| 语言种类 | 中文、英文 |
交互流程
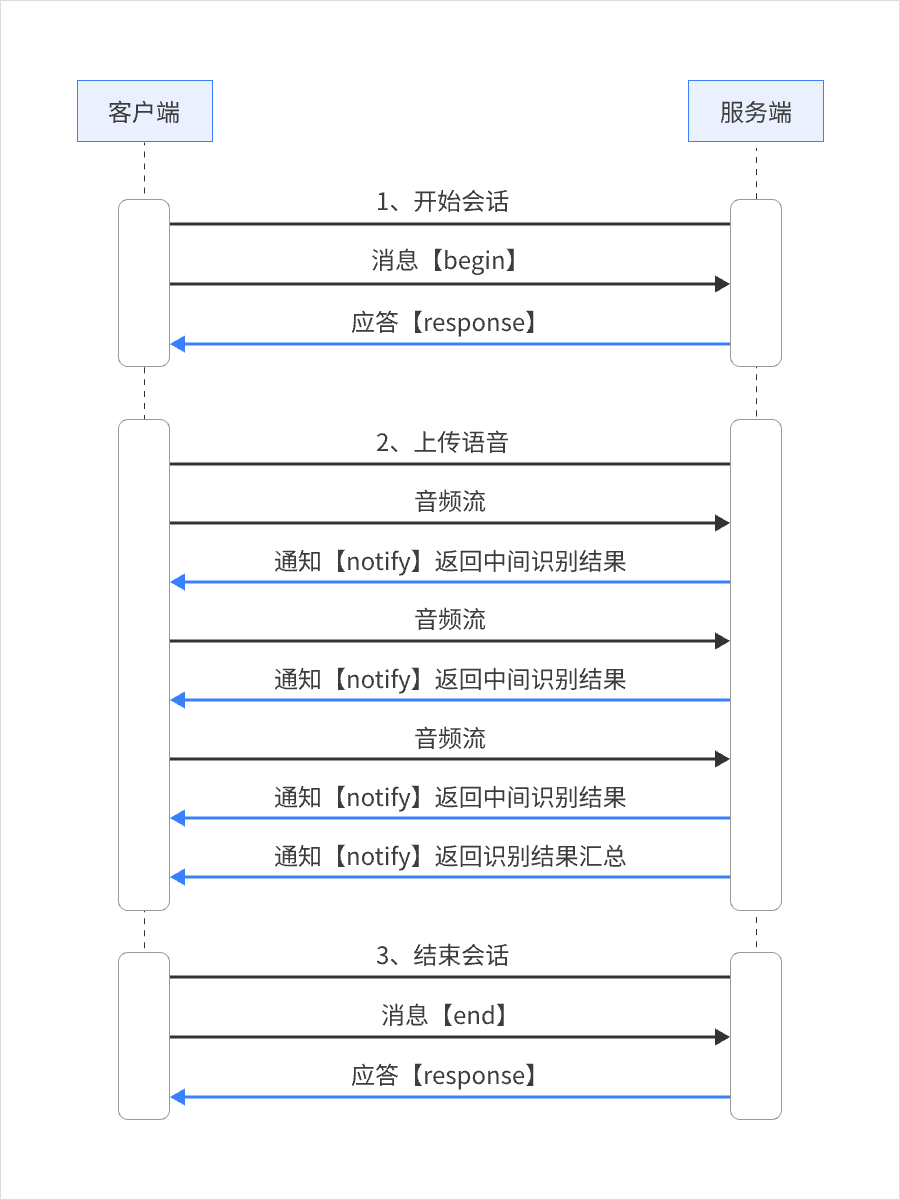
握手阶段
参数详细说明,请参考公共参数
接口地址
wss://sdk.cloudroom.com/CLOUDMEETING-API/v1/recognit?{请求参数}
参数格式
auth=base64(RequestId=xxx&CompID=xxx&SecretKey=xxx&AppId=xxx)
参数生成
由参数拼接后对字符串进行base64编码。
假如 RequestId为2d95a5fea3845dea0d84db153b10ee0f,CompID为1,SecretKey为4bc877221e5fc88d9978f9a788058241,AppId为demo
则进行base64编码加密之后得到的auth参数为
UmVxdWVzdElkPTJkOTVhNWZlYTM4NDVkZWEwZDg0ZGIxNTNiMTBlZTBmJkNvbXBJRD0xJlNlY3JldEtleT00YmM4NzcyMjFlNWZjODhkOTk3OGY5YTc4ODA1ODI0MSZBcHBJZD1kZW1v
请求示例
wss://sdk.cloudroom.com/CLOUDMEETING-API/v1/recognit?auth=UmVxdWVzdElkPTJkOTVhNWZlYTM4NDVkZWEwZDg0ZGIxNTNiMTBlZTBmJkNvbXBJRD0xJlNlY3JldEtleT00YmM4NzcyMjFlNWZjODhkOTk3OGY5YTc4ODA1ODI0MSZBcHBJZD1kZW1v
实时通信阶段
握手成功后,进入实时通信阶段,此时客户端的主动操作有以下几种:
- 请求开始会话
- 上传语音数据
- 修改输出语言
- 上传结束标识
被动操作有两种:
- 接收识别结果
- 接收应答
请求开始会话
客户端发起请求,在开始会话请求消息中需要设置初始参数。
{
    "message":"begin",
    "itn":0,
    "sid":123,
    "params":{
        "languages":["zh"],
        "time":0
    }
}
参数说明:
| 名称 | 类型 | 是否必传 | 说明 |
|---|---|---|---|
| message | String | 是 | 开始会话消息名称,固定值为 begin |
| sid | Long | 是 | 消息序号ID |
| itn | Integer | 否 | 是否开启ITN,默认0。0表示不开启,1表示开启,开启时中文数字转为阿拉伯数字输出 |
| params | Object | 是 | 配置参数 |
| ∟sampleRate | Integer | 否 | 音频采样率,支持16k(sampleRate=16000)和8k(sampleRate=8000),默认值为16000 |
| ∟languages | String[] | 否 | 输出语言,默认值为bypass。支持值:zh(中文)、en(英文)、bypass(原文) |
| ∟time | Long | 否 | unix时戳毫秒 |
应答:
{
    "message":"response",
    "name":"begin",
    "sid":123,
    "error":{
        "code":0,
        "desc":""
    }
}
上传语音数据
在实时语音识别过程中,客户端不断构造message发送到服务端,内容为经过Base64编码的音频数据。
{
  "message":"proceed",
  "params":{
    "audio":"exSI6ICJlbiIsCgkgICAgInBvc2l0aW9uIjogImZhbHNlIgoJf..."
  },
  "sid":123
}
参数说明:
| 名称 | 类型 | 是否必传 | 说明 |
|---|---|---|---|
| message | String | 是 | 上传语音消息名称,固定值为 proceed |
| sid | Long | 是 | 消息序号ID |
| params | Object | 是 | 配置参数 |
| ∟audio | String | 是 | 音频数据,采用base64编码 |
无应答
修改输出语言
客户端发送请求,修改语音识别输出的语言类型。
{
  "message": "modify_lang",
  "languages": ["zh","en", "bypass"],
  "sid": 123
}
参数说明:
| 名称 | 类型 | 是否必传 | 说明 |
|---|---|---|---|
| message | String | 是 | 修改输出语言消息名称,固定值为 modify_lang |
| sid | Long | 是 | 消息序号ID |
| languages | String[] | 是 | 输出语言, zh:中文; en:英文; bypass:原文 |
应答:
{
  "message":"response",
  "name":"modify_lang",
  "sid":123,
  "error":{
    "code":0,
    "desc":""
  }
}
上传结束标识
音频数据上传完成后,客户端需要发送一个消息通知服务端作为结束标识。
{
    "message":"end",
    "params":{
        "exit":true
    },
    "sid":123
}
参数说明:
| 名称 | 类型 | 是否必传 | 说明 |
|---|---|---|---|
| message | String | 是 | 上传结束标识消息名称,固定值为 end |
| sid | Long | 是 | 消息序号ID |
| params | Object | 是 | 配置参数 |
| ∟exit | Boolean | 是 | 是否要关闭连接,true:是;false:否 |
应答:
{
    "message":"response",
    "name":"end",
    "sid":123,
    "error":{
        "code":0,
        "desc":""
    }
}
接收识别结果
交互过程中,服务端不断返回语音识别结果到客户端。
应答:
{
    "message":"notify",
    "sid":123,
    "error":{
        "code":0,
        "desc":"ok"
    },
    "is_final":true,
    "result":[
        {
            "time":1722505796006,
            "capsEnd":true,
            "caps":[
                {
                    "lang":"zh",
                    "text":"5rWL6K+V6K+t6Z+z6K+G5Yir"
                },
                {
                    "lang":"en",
                    "text":"dGVzdCBzcGVlY2ggcmVjb2duaXRpb24="
                },
                {
                    "lang":"bypass",
                    "text":"5rWL6K+V6K+t6Z+z6K+G5Yir"
                }
            ]
        }
    ]
}
返回值
| 参数 | 类型 | 说明 |
|---|---|---|
| message | String | 消息名称 |
| sid | Long | 消息序号ID |
| is_final | Boolean | true 表示识别结束 |
| error | Object | 错误码信息 |
error 字段说明:
| 参数 | 类型 | 说明 |
|---|---|---|
| code | Integer | 错误码 |
| desc | String | 描述 |
识别结果result字段说明:
| 参数 | 类型 | 说明 |
|---|---|---|
| time | Long | unix时戳毫秒 |
| capsEnd | Boolean | false 表示 caps 是中间结果,仅返回原文(bypass);true 表示 caps 是最终结果,可包含多种语言的输出 |
| caps | Object[] | 识别的句子结果 |
caps 字段说明:
| 参数 | 类型 | 说明 |
|---|---|---|
| lang | String | 输出语言, zh:中文; en:英文; bypass:原文 |
| text | String | 识别结果,采用base64编码 |
错误码
上述接口在消息体中返回请求的错误码,详情请参见 错误码